LoRA キャラ学習 作り方
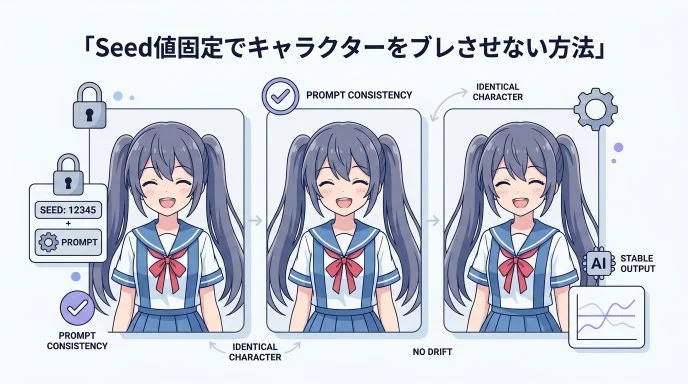
キャラクターを自由に生成できるのは、AI画像生成の醍醐味だ。でも、毎回「黒髪、青い目、赤いリボン、笑顔」ってプロンプトを打ち込むの、面倒じゃない?
そんなとき、LoRA(Low-Rank Adaptation)があれば、そのキャラを「記憶」させられる。一度学習させれば、トリガーワード一つで、そのキャラがどんなポーズでも、どんな背景でも、勝手に出て来る。
でも、作り方は意外とハードルが高い。
単に画像を投げて「学習」ボタンを押すだけでは、顔が崩れる。髪の毛が変形する。服の質感が消える。なぜか、いつも同じ表情しか出ない。
ちゃんと作るには、データの選び方、設定の微調整、環境の整え方——全部が、ちゃんとつながってないと、意味がない。
データは「質」より「量」じゃない
「50枚あれば大丈夫」と言われるけど、実際は15枚で完璧に学習できるケースもある。逆に、100枚使っても、全部同じ角度の写真なら、まったく役に立たない。
必要なのは、バラエティ。
- 正面・横顔・後ろ姿
- 笑顔・無表情・怒った顔
- 普段着・制服・コスプレ
- 室内・屋外・光の方向が違う
背景が複雑な写真は、AIが「背景」をキャラの一部と誤認識する。ブレた写真は、学習を妨げるノイズになる。
「これ、いい写真だよね?」って思っても、AIは
「これは、キャラじゃない」って判断する。
キャプションは「手動」が命
WD14 TaggerやBLIP2は便利。でも、自動生成されたキャプションは、まるで「AIが見た夢」みたい。
「少女」
「髪」
「目」
「服」——そんな曖昧なタグしかついてない。それじゃ、AIは「誰?」ってなる。
だから、手動で、具体的に追加する。
- 「黒髪ロング」
「青い瞳」
「左頬のほくろ」 - 「赤いリボン首飾り」
「片耳にイヤリング」 - 「小さな口元」
「ほんの少し歪んだ笑顔」
この細かいタグが、AIの「記憶」を形作る。
トリガーワードは、1つでいい。でも、その単語は、誰も使ってないものにしたほうがいい。
「mychar_v1」は、すでに誰かが使ってる。検索で引っかかって、他の人のLoRAと混ざるリスクがある。
「sakuramochi_03」みたいに、ちょっと変な組み合わせが、実は最強。
ツールは「選ぶ」より「使う」
Kohya_ssは、設定が多すぎて怖い。でも、それが強みでもある。
初心者は、Flux Gymがいい。設定が少ないから、迷わない。
でも、Flux GymはFLUX.1専用。SD1.5やSDXLを使いたいなら、Kohya_ssしか選択肢がない。
クラウドを使うか、自前PCか——
無料のGoogle Colabは、時間が限られてる。学習中にセッションが切れる。焦る。
RunPodは、RTX 4090が$1〜3で使える。一回の学習で、10分で終わる。コスパが良すぎる。
「無料でやりたい」って気持ち、分かる。でも、1日かけても終わらない学習を、何回も繰り返すより、$2で一発で終わらせるほうが、結局、時間とストレスが減る。
学習後、うまくいかない理由
「学習は成功したのに、出力が全然違う」——これは、ほとんどの人が通る道。
原因は、たいてい3つ。
- 強度(weight)が高すぎる
- 他のLoRAと競合してる
- プロンプトに「キャラ」のキーワードが入ってない
強度は、0.6〜0.8が目安。1.0にすると、顔が変形しやすい。
複数のLoRAを同時に使うときは、全部の強度を0.5以下に下げる。そうしないと、AIが「どっちのキャラ?」って混乱する。
プロンプトに「mychar_v1」を入れてないのに、キャラが出るはずがない。
「こんなに頑張ったのに…」って、思っても、プロンプトにその単語がなければ、AIは「知らない」。
商用利用は、危険な罠
「AIで作ったキャラを、グッズにしよう」——これ、すごく魅力的。
でも、FLUX.1のモデルは、非商用限定。SDXLは商用可だけど、条件がある。
学習に使った画像の著作権も、ちゃんと確認してないといけない。
誰かのイラストをトレースして、LoRAにした場合——それは、著作権侵害。
AIが「生成」したからって、それが
「自分のもの」になるわけではない。
便利だけど、手間がかかる
LoRAは、魔法のツールじゃない。
一発で完璧なキャラが作れるわけじゃない。何度も失敗して、修正して、また失敗して……
でも、その手間を乗り越えた先に、本当に「自分のキャラ」が、自由に動く世界がある。
「毎回同じプロンプトを打つ」って、もう、やめられる。
「このキャラ、このポーズで、この光で、この背景で」——それだけの言葉で、AIが全部を理解してくれる。
だから、面倒でも、ちゃんと作る価値はある。
(これ、マジで便利です)
 羽田義和
でも、本当に毎回、画像を50枚用意して、タグを手動で入れて、学習を何回も繰り返すの? もっと楽な方法ないの?
楽な方法は、ない。AIは、手間を省く代わりに、あなたの「細かいこだわり」を学ぶ必要がある。それが、キャラの個性になる。
羽田義和でも、AI画像生成自体、もう十分便利じゃない? LoRAまでやる必要ある?
便利さと、自由さは違う。AIは、あなたの「想像」を形にするツール。LoRAは、その想像を、ずっとずっと、使い続けるための鍵。
LoRA キャラ学習 作り方
- 画像は20〜50枚、表情・角度・衣装をバラバラに用意
- 背景はシンプル、顔が大きく、ブレていないものを選ぶ
- WD14 Taggerで自動タグ生成後、手動で細かい特徴を追加
- トリガーワードは、誰も使ってないユニークな単語に設定
- Kohya_ssかFlux Gymで学習。初心者はFlux GymでFLUX.1を試す
- 学習パラメータは、初期値から少しずつ調整。Epochは5〜10が目安
- 学習後は、.safetensorsファイルをmodels/Loraフォルダに配置
- プロンプトにトリガーワードを入れて、強度は0.6〜0.8で試す
- 商用利用は、モデルのライセンスを必ず確認。著作権に注意
AIは、あなたの手間を減らすためにある。でも、本当の価値は、あなたのこだわりが、どれだけ正確に伝わるか、にある。
手間はかかる。でも、その先に、誰にも真似できない、あなただけのキャラがいる。
これを読めば、あなたに適した稼げるツールが見つかります!
アダルトアフィリ用ツール多すぎて「どれ買えばいいか分からん」人向けに、
✅ 全7ツールを用途別に整理
✅ 阿修羅/読収のEX版ポジションも明確化
✅ WP派か静的HTML派かで分岐
までまとめた比較記事を書きました。
「最初の1本どれにするか」迷ってる人ほど刺さる内容なので、ツール検討中の人はぜひチェックしてみてください。↓↓
この記事を書いた人
関連記事
今すぐ無料でアダルトアフィリエイトを学ぶ。
「人間の根本的な欲求に基づくビジネスは絶対に廃れない」「稼ぎ易い。」「副業失敗者の最後の砦」